Eigene KI-Hardware statt API-Kostenfalle: unser 19-GPU-Cluster in der Praxis
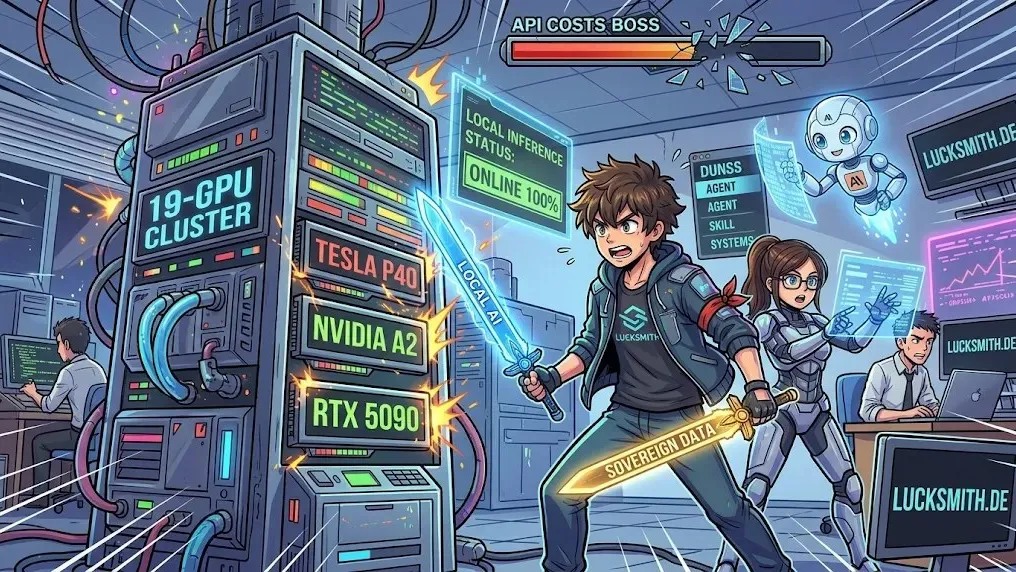
Gefühlt hat gerade jede Agentur „KI“ im Angebot. Schaut man genauer hin, steckt dahinter oft dasselbe: ein Eingabefeld, ein paar Zeilen Code und ein Aufruf an die API eines großen US-Anbieters. Das ist nicht verwerflich, für viele Aufgaben ist es sogar die richtige Lösung. Aber es ist eben nur ein Wrapper. Die Daten verlassen das Haus, die Kosten wachsen mit jedem Aufruf, und wenn der Anbieter Preise, Modelle oder Nutzungsbedingungen ändert, hängt das eigene Produkt daran.
Wir haben uns bei Lucksmith für einen anderen Weg entschieden: eigene KI-Hardware. In diesem Beitrag nehmen wir Sie mit hinter die Kulissen unseres GPU-Clusters und beantworten die Frage, die uns Kunden am häufigsten stellen: Wann lohnt sich lokales Self-Hosting, und wann ist eine Cloud-API die bessere Wahl?
Was in unserem Cluster steckt
Unser Cluster besteht aus 19 GPUs in Servern mit zusammen 2,5 TB ECC-Arbeitsspeicher. Die Grafikkarten sind bewusst keine Einheitsware, sondern eine Mischung aus drei Welten:
Nvidia Tesla P40: erprobte Rechenzentrumskarten mit viel Grafikspeicher. Sie sind nicht mehr die neuesten, aber für viele Inferenz-Aufgaben, bei denen ein Modell vor allem in den Speicher passen muss, nach wie vor solide Arbeitstiere.
Nvidia A2: kompakte, sparsame Inferenzkarten für den Dauerbetrieb. Sie eignen sich für kleinere Modelle und Dienste, die rund um die Uhr laufen und schnell antworten sollen.
Nvidia RTX 5090: die aktuelle Spitzenklasse für alles, was viel Rechenleistung braucht: größere Modelle, schnelle Antworten bei vielen gleichzeitigen Anfragen und Experimente mit neuen Modellen.
Der ECC-Arbeitsspeicher ist kein Detail für Datenblätter. ECC erkennt und korrigiert Speicherfehler, bevor sie zu falschen Ergebnissen oder Abstürzen führen. Bei Systemen, die tagelang ohne Pause laufen und große Modelle im Speicher halten, ist das genau die Art von Zuverlässigkeit, die man nicht bemerkt, solange sie da ist.
Die Server sind nicht gemietet. Wir haben sie selbst zusammengebaut und selbst ins Rechenzentrum in Deutschland gebracht. Betrieben werden sie in unserem eigenen Kubernetes-Cluster, so wie der Rest unserer Infrastruktur auch.
Warum eine Mischung statt einer einzigen Kartenklasse?
Nicht jede KI-Aufgabe braucht die schnellste Karte. Ein kleines Modell, das Anfragen sortiert oder Texte zusammenfasst, läuft auf einer sparsamen Karte völlig ausreichend. Ein großes Modell für Übersetzungen oder anspruchsvolle Texte braucht dagegen viel Speicher und Rechenleistung. Mit einer gemischten Flotte können wir jedem Dienst die Hardware geben, die zu ihm passt, statt alles auf die teuerste Klasse zu legen. Das ist am Ende dieselbe Logik, die wir auch bei Software anwenden: das passende Werkzeug für die Aufgabe, nicht das größte.
Was auf dem Cluster heute läuft
Der Cluster ist kein Showroom, er trägt echte Arbeit. Auf unserer eigenen Website zum Beispiel:
Der Live-Chat: Fragen von Besuchern beantwortet ein Modell, das auf unserer eigenen Hardware läuft. Die Gespräche verlassen dabei nicht unsere Infrastruktur.
Die KI-Preisschätzung: Wer auf unserer Startseite sein Projekt beschreibt, bekommt eine erste Einschätzung, berechnet von einem Modell auf unserem Cluster.
Übersetzungen: Unsere Website gibt es in neun Sprachen. Vorschläge für Übersetzungen erzeugt ein größeres Modell auf eigener Hardware, freigegeben werden sie von Menschen.
Agenten-Systeme: Mit DUNSS entwickeln wir ein System, in dem mehrere KI-Agenten mit eigenen Fähigkeiten zusammenarbeiten. Gerade hier zeigt sich, warum eigene Hardware so wertvoll ist (dazu gleich mehr).
Mehrere Anwendungen teilen sich dabei denselben Modellserver im Cluster. Ein Modell, das einmal geladen ist, bedient also den Chat genauso wie die Preisschätzung. Das spart Speicher und hält die Antwortzeiten kurz.
Wann lohnt sich lokales Self-Hosting?
Eigene Hardware ist kein Selbstzweck. Sie lohnt sich, wenn mindestens einer der folgenden Punkte auf Ihr Vorhaben zutrifft.
1. Die Daten sind sensibel
Kundendaten, Verträge, Angebote, interne Dokumente, Gesundheitsdaten: Sobald solche Inhalte an eine externe API gehen, braucht es Auftragsverarbeitung, Prüfung des Drittlandtransfers und viel Vertrauen in die Zusagen des Anbieters. Läuft das Modell auf eigener Hardware in Deutschland, stellt sich die Frage gar nicht erst. Die Daten bleiben dort, wo sie hingehören. Für viele Unternehmen im Mittelstand ist das nicht nur ein gutes Gefühl, sondern die Voraussetzung, um KI überhaupt einsetzen zu dürfen.
2. Es laufen viele Anfragen, oft automatisch
Ein Mensch, der ab und zu eine Frage an ein Sprachmodell stellt, verursacht überschaubare API-Kosten. Ganz anders sieht es bei Agenten-Systemen aus. Ein Agent denkt nicht in einem Schritt, sondern in vielen: Er plant, ruft Werkzeuge auf, prüft Ergebnisse, korrigiert sich, fragt einen zweiten Agenten. Aus einer Aufgabe werden schnell Dutzende Modellaufrufe, und jeder davon schickt den bisherigen Verlauf erneut mit. Bei einer API, die pro verarbeitetem Text abrechnet, wachsen die Kosten damit nicht linear mit der Zahl der Aufgaben, sondern mit der Zahl der Denkschritte.
Genau das ist die Kostenfalle: Ein Agent, der im Test ein paar Euro kostet, kann im Dauerbetrieb zu einer Rechnung werden, die niemand eingeplant hat. Auf eigener Hardware ist ein zusätzlicher Denkschritt dagegen vor allem eine Frage der Rechenzeit, nicht einer weiteren Zeile auf der Abrechnung. Deshalb entwickeln und betreiben wir DUNSS auf unserem eigenen Cluster.
3. Die Kosten sollen planbar sein
Eigene Hardware kostet Geld, keine Frage: Anschaffung, Strom, Rechenzentrum, Wartung und das Wissen, um alles zu betreiben. Aber diese Kosten sind planbar. Sie hängen nicht davon ab, wie viele Besucher heute den Chat nutzen oder wie oft ein Agent eine Aufgabe neu angeht. Wer KI fest in Produkte und Abläufe einbaut, schätzt diese Planbarkeit oft höher als den günstigen Einstieg einer API.
4. Unabhängigkeit ist ein Ziel
Wer nur über eine API arbeitet, ist an die Entscheidungen des Anbieters gebunden: Modelle werden abgekündigt, Antworten ändern sich nach einem Update, Preise steigen, Nutzungsbedingungen werden angepasst. Mit eigener Hardware entscheiden Sie selbst, welches Modell in welcher Version läuft und wann Sie wechseln. Offene Modelle entwickeln sich derzeit rasant, und ein neues Modell ist bei uns eine Frage von Herunterladen und Testen, nicht von Vertragsverhandlungen.
Wann eine Cloud-API die bessere Wahl ist
Zur Ehrlichkeit gehört auch die andere Seite. Wir empfehlen unseren Kunden nicht pauschal eigene Hardware. Eine Cloud-API ist oft die bessere Lösung, wenn:
Sie gerade erst ausprobieren, ob eine KI-Idee überhaupt funktioniert. Ein Prototyp mit einer API ist schnell gebaut, und die Erkenntnis ist wertvoller als jede Hardware.
Die Nutzung gering oder unregelmäßig ist. Wer ein paar Dutzend Anfragen im Monat hat, braucht keinen eigenen Server.
Sie die stärksten geschlossenen Modelle brauchen. Für manche Aufgaben sind die großen proprietären Modelle derzeit schlicht besser, und die gibt es nur über die API ihrer Anbieter.
Keine sensiblen Daten im Spiel sind. Wenn es um öffentliche Texte oder allgemeines Wissen geht, entfällt das stärkste Argument für eigene Hardware.
In der Praxis bauen wir unsere Systeme deshalb so, dass das Modell austauschbar ist. Unsere Anwendungen sprechen mit einer Schnittstelle, hinter der wahlweise unser eigener Modellserver oder eine externe API stehen kann. So lässt sich mit einer API starten und später auf eigene Hardware umziehen, oder umgekehrt, ohne die Anwendung neu zu schreiben.
Die richtige Frage ist nicht „Cloud oder eigene Hardware?“, sondern: Welche Daten fließen, wie oft wird das Modell aufgerufen, und wie abhängig wollen Sie sein?
Was wir beim Betrieb gelernt haben
Eigene KI-Hardware zu betreiben heißt auch, Probleme selbst zu lösen, die bei einer API der Anbieter für einen löst. Ein paar Lehren aus unserem Alltag:
Modelle brauchen Pflege. Einstellungen wie Temperatur, maximale Antwortlänge oder ob ein Modell vor der Antwort „nachdenken“ soll, haben großen Einfluss auf Qualität und Geschwindigkeit. Das muss man für jede Anwendung einzeln abstimmen.
Offene Modelle haben Eigenheiten. Ein Modell, das in vielen Sprachen trainiert wurde, antwortet gelegentlich in der falschen. Solche Fälle fangen wir im Code ab, statt uns auf das Modell zu verlassen.
Geladene Modelle sind Gold wert. Ein großes Modell in den Grafikspeicher zu laden dauert. Wie lange es danach im Speicher bleibt, entscheidet darüber, ob die nächste Anfrage sofort oder erst nach einer Wartezeit beantwortet wird.
Ohne Ausweichweg geht es nicht. Wenn ein Modell einmal nicht antwortet, muss die Anwendung trotzdem funktionieren. Unsere Preisschätzung fällt in diesem Fall zum Beispiel auf eine Berechnung ohne KI zurück.
Ist eigene KI-Hardware etwas für Ihr Unternehmen?
Wenn Sie KI mit sensiblen Daten einsetzen wollen, an Agenten-Systemen arbeiten oder schon heute merken, dass die API-Rechnung schneller wächst als der Nutzen, lohnt sich ein genauer Blick. Dafür müssen Sie nicht sofort eigene Server kaufen. Oft ist der erste Schritt, die Anwendung so zu bauen, dass das Modell austauschbar ist, und dann anhand echter Nutzungsdaten zu entscheiden.
Genau dabei helfen wir: von der Idee über die Wahl des passenden Modells bis zum Betrieb auf Infrastruktur in Deutschland. Mehr dazu finden Sie unter KI-Automatisierung, Hosting in Deutschland und individuelle Softwareentwicklung. Oder Sie vereinbaren direkt ein Erstgespräch, und wir schauen gemeinsam, welcher Weg für Ihr Vorhaben der richtige ist.
Starte noch heute dein neues Projekt mit uns
Vereinbare ein kostenloses Erstgespräch, schreib uns an hallo@lucksmith.io oder ruf einfach durch: +49 6772 9198690